研究所动态
我所一篇对抗攻击可迁移性的工作被CCF A类期刊IEEE TIFS录用
发布时间:2026年9月16日
由我所师生合作完成的论文“Harmonizing Intra-coherence and Inter-divergence in Ensemble Attacks for Adversarial Transferability”被CCF A类期刊IEEE TIFS(IEEE Transactions on Information Forensics and Security)录用,该论文由我所博士生马朝阳,已毕业博士生岳景杭等人,在我所王晶、林友芳,武志昊三位老师,以及清华大学卢旺老师、南洋理工大学Wang Lipo老师的指导下完成。
该研究围绕深度模型黑盒对抗迁移性评估任务开展。现有集成攻击技术存在三项痛点:一是梯度几何冲突,不同架构的代理模型对同一输入产生的梯度方向不一致甚至相互抵消,简单平均造成破坏性干涉,关键对抗信号被彼此消解;二是权重分配僵化,主流方法采用均匀或固定权重,忽略各代理模型对抗敏感性的显著差异,高质量梯度被低效代理稀释;三是跨架构迁移鸿沟明显,卷积网络与视觉Transformer之间的迁移效果急剧衰减,难以支撑对异构模型体系的统一安全研判。
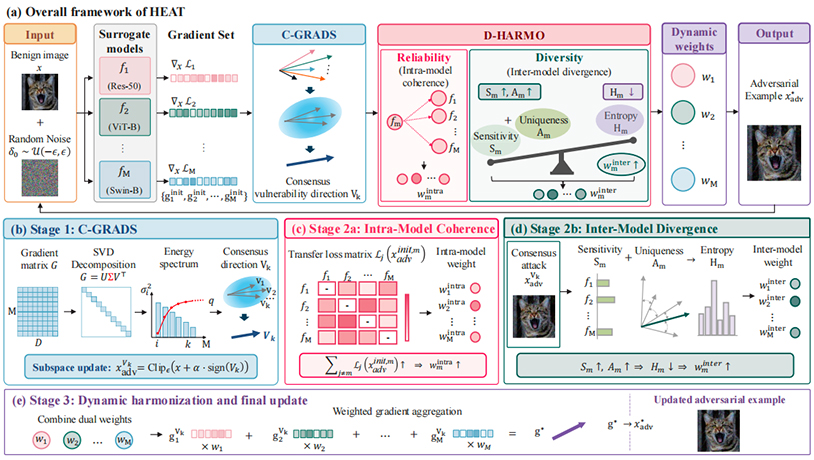
针对上述痛点,研究团队提出融合域泛化思想的集成对抗攻击框架 HEAT。该工作首次将域泛化视角系统性引入集成对抗攻击设计,把每个代理模型视作由其损失几何所定义的独立"域",从而将"由已知代理迁移至未知目标"重新表述为跨域泛化问题。框架由两个协同模块构成:共识梯度方向合成器对集成梯度矩阵执行奇异值分解,提取低秩共识子空间,在滤除模型特有噪声的同时保留跨架构共享的脆弱性模式,从几何层面化解梯度冲突;双和谐权重编排器同步刻画模型内一致性与模型间差异性,前者衡量各代理梯度的可迁移程度,后者奖励梯度多样性以避免集成塌缩到同质解,两类权重共同调制各模型梯度并合成最终更新方向。该框架为即插即用设计,可与主流迭代优化器直接组合。
该研究为人工智能系统的安全评估提供了更可靠的检验手段。本文的方法能够在不接触系统内部的前提下,提前暴露不同模型之间共有的安全隐患,对提升人工智能应用的安全性具有实际意义。