研究所动态
我所7篇论文被国际顶级学术会议NeurIPS 2026录用
发布时间:2026年10月13日
近日,人工智能与机器学习领域国际顶级会议NeurIPS 2026公布录用结果,由我所师生共同完成的5篇论文被大会录用。Neural Information Processing Systems (NeurIPS)是中国计算机学会(CCF)推荐的A类国际学术会议。今年 NeurIPS 主赛道共收到 30709 份有效论文投稿,录用7900 篇,录用率为 25%。此次我所被录用的论文的相关信息如下:
论文一
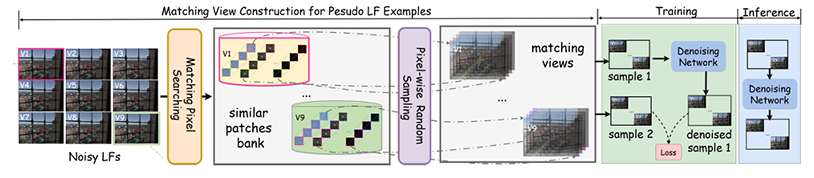
Matching2Matching: Zero-Shot Light Field Image Denoising with Matching View Construction
该论文由我所张硕老师、硕士生田倩、博士生高晨和郭龙钊合作完成,林友芳老师参与指导工作。
近年来,Noise2Noise为无需干净数据的图像去噪学习提供了有效思路。然而,现有二维图像零样本去噪方法通常依赖局部相似性或非局部自相似性构造训练图像对,在纹理丰富的复杂场景中难以保证可靠性。与二维图像不同,四维光场能够记录同一场景的多个视角,不同视角中相互独立的噪声为跨视角构造训练图像对提供了可能。本文利用光场中的跨视角对应关系,提出一种在四维光场中实现Noise2Noise的新方法。具体而言,我们设计了Matching2Matching(M2M)框架,为光场中的每个视角构造匹配视图。该框架沿极线搜索对应图像块,并结合可见性与视差一致性约束,生成几何一致的训练样本。利用构造的视图,去噪网络能够以零样本方式进行训练,无需任何额外数据。实验结果表明,该方法能够有效抑制噪声,同时保持跨视角一致性和精细细节。在合成噪声与真实噪声的定量和定性评估中,M2M均显著优于现有零样本方法,在不依赖外部训练数据的情况下展现出较强的泛化能力。
论文二
Exploring the Epipolar Consistency for Light Field Deraining
该论文由我所博士生高晨、王文彬在林友芳、张硕老师指导下完成。
光场图像丰富的空间—角度信息为雨天场景恢复提供了重要的跨视角冗余信息。然而,雨条纹具有半透明和空间离散等特性,不仅会遮挡背景细节,还会破坏光场固有的跨视角几何一致性,给光场去雨带来较大挑战。尽管已有相关方法被提出,但现有研究仍存在两个关键局限:其一,现有光场雨数据多由单幅图像雨模型直接扩展得到,缺乏对雨层跨视角一致性、多层累积以及与背景遮挡关系的建模,与真实雨天场景存在较大差异;其二,现有方法通常依赖深度估计进行跨视角对齐,而雨条纹会干扰深度估计,同时直接学习雨与背景之间的映射也难以充分解耦二者,容易产生残余雨纹和结构失真。
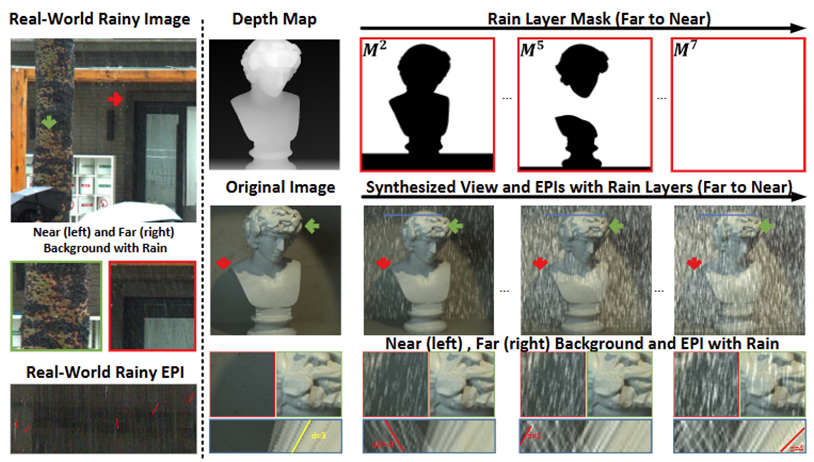
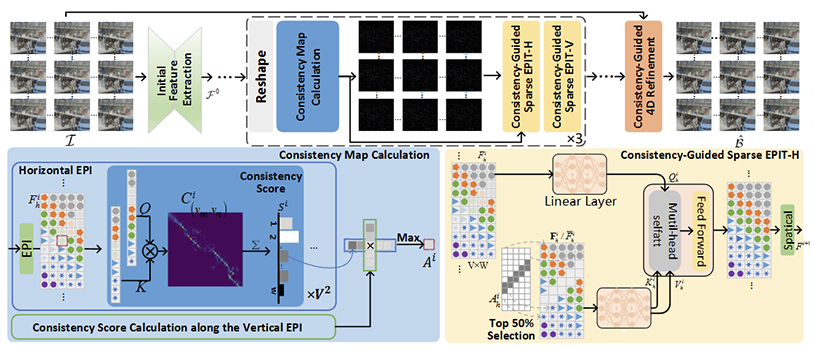
针对上述问题,我们首先分析光场中雨层的跨视角一致性、多层累积效应及遮挡关系,建立了一种一致性约束的光场雨模型,并据此构建了更加符合真实成像过程的光场去雨数据集。 在模型结构方面,我们进一步提出一致性引导恢复网络 CGRNet,利用雨区对极线一致性的破坏特性构建一致性图,感知不同区域的退化程度;随后通过一致性引导稀疏 EPI Transformer 和 4D Refinement 模块,自适应选择其他视角中未退化或轻度退化的可靠背景信息,对受雨影响区域进行恢复。实验结果表明,所提出的数据集能够有效提升模型在真实场景中的泛化能力,CGRNet 在合成和真实光场雨场景中均取得了更优的恢复效果。
论文三
FEAD: Fine-Grained Epipolar Attention Diffusion for Large-Disparity Light Field Spatial Super-Resolution
该论文由我所硕士生王文彬担任第一作者,林友芳老师、在读博士生高晨及张硕老师共同完成。
该研究围绕大视差场景下的光场图像空间超分辨率重建任务展开。光场成像能够同时记录场景的空间与角度信息,为三维场景理解、深度估计和高质量图像重建提供丰富的视觉信息。然而,受限于光场成像设备空间分辨率与角度分辨率之间的固有制约,如何充分利用不同视角之间的互补信息,实现高质量的图像超分辨率重建,仍然是一项重要挑战。现有方法主要存在三方面局限:一是跨视角对应关系建模不充分,多数方法依赖隐式特征交互,难以准确建立不同视角之间的像素级关联;二是大视差场景下几何对齐误差显著,传统低分辨率特征匹配或粗粒度视差估计容易在物体边界、遮挡及复杂纹理区域产生错误对应;三是跨视角信息融合缺乏精确几何引导,错误匹配的特征可能在重建过程中相互干扰,造成纹理模糊、结构失真与细节丢失。
针对上述问题,研究团队提出了一种基于精细极线注意力扩散的光场超分辨率重建框架FEAD。该研究从跨视角几何对应关系的准确性出发,揭示了精细视差注意力建模对于光场超分辨率重建性能的重要影响,并创新性地将扩散模型引入极线注意力的渐进式优化过程。框架包含三个相互协同的关键设计:首先,高分辨率极线注意力建模在目标重建分辨率下显式刻画不同视角沿极线方向的对应关系,为复杂视差场景中的精细特征匹配提供几何依据;其次,条件残差扩散式注意力细化将传统扩散模型的建模对象由图像内容转向跨视角注意力分布,通过逐步修正初始注意力中的对应偏差,提高复杂区域的匹配准确性与几何一致性;最后,极线注意力引导的跨视角对齐与自适应融合利用细化后的对应关系,对不同视角的特征进行显式对齐与互补信息聚合,实现高频纹理和场景结构的精细恢复。实验结果表明,FEAD在多个光场超分辨率基准数据集上取得了先进的重建性能,尤其在中、大视差及复杂几何场景中表现出显著优势,部分测试设置下PSNR指标相比已有先进方法提升约0.73 dB。
该研究为复杂场景下的光场图像高质量重建提供了新的技术思路。一方面,通过将扩散模型应用于几何对应关系的优化,而非直接生成图像内容,拓展了生成式模型在几何感知视觉任务中的应用方式;另一方面,精细化的跨视角对齐与信息融合机制,有助于提升复杂三维场景中的图像恢复质量,为计算摄影、三维视觉感知、智能成像及高分辨率视觉重建等领域提供技术参考。
论文四
Towards High Semantic Fidelity: Hyperdimensional Symbolic Messages in Multi-Agent Communication
该论文由我所博士生宋守诚在林友芳老师和吕凯老师指导下完成。
多智能体强化学习中,通信是实现协同决策与行为协调的重要基础。在非理想信道下,通信的有效性关键取决于智能体间传递的语义能否被完整保留并准确理解,即语义保真度,具体包含传输保真与转换保真两个方面。现有数值消息结构简单、便于转换,但抗干扰能力弱;神经消息虽可通过定制损失提升鲁棒性,却因黑盒编码难以恢复原始语义。二者难以同时满足高语义保真,成为多智能体通信面临的关键挑战。
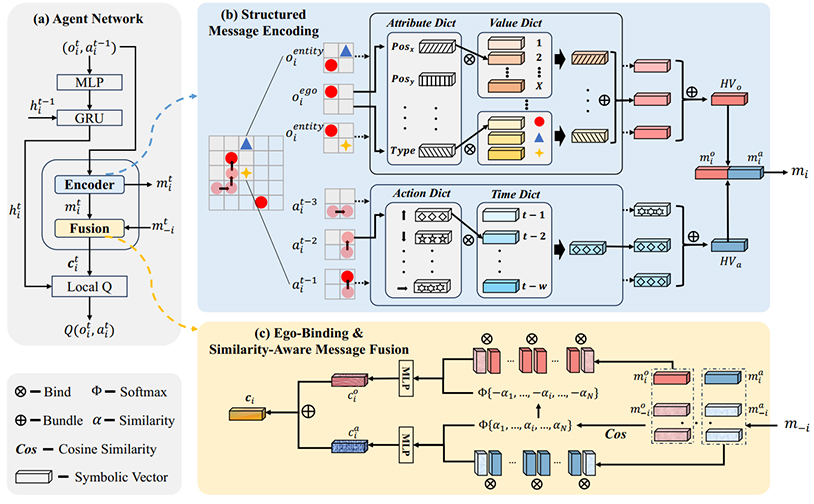
针对这一问题,本文提出了一种新型消息格式——超维符号消息(Hyperdimensional Symbolic Messages, HSM)及其通信框架 Herm。为提升传输保真,Herm 设计了实体-属性-值结构化编码管道,将智能体的局部观测与历史动作映射到高维符号空间,在有限通信开销下抑制语义纠缠;为提升转换保真,Herm 引入以接收者为中心的 ego-binding 机制,将全局广播消息投影到接收者局部语义子空间,并设计相似度感知双分支融合模块,分别处理观测补充与行为理解,防止关键决策语义被稀释。此外,本文还提出基于代数逆操作的迭代解码方案,实现消息到语义的显式转换,并进一步探索了 HSM 与大语言模型结合的混合决策范式。 在标准多智能体基准上的实验表明,与基线方法相比,Herm 在多种随机噪声和对抗噪声场景下均展现出优越的鲁棒性,同时保持出色的结构可读性与语义转换能力。
论文五
Group Perspective Matters: Regulating Debate Relationships Can Mitigate Blind Conformity in Multi-Agent Debate
该论文由我所博士生吴昊、宋守诚、姚畅在林友芳老师、万怀宇老师和吕凯老师的指导下完成。
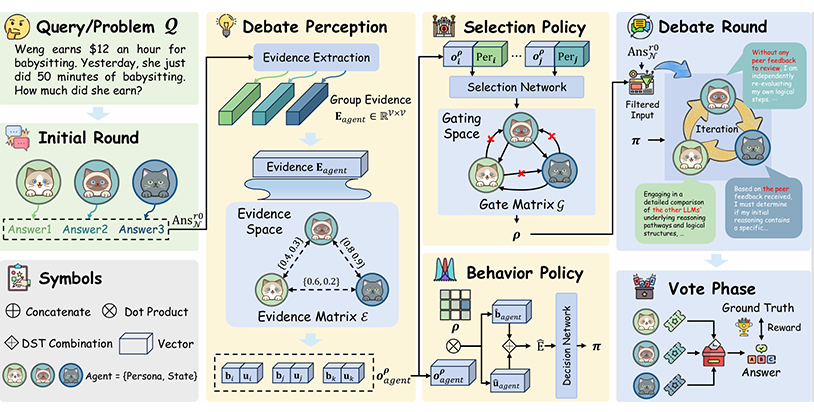
多智能体辩论通过多个智能体之间的多轮交互,显著提升了大语言模型的推理能力。然而,参与辩论的大语言模型极易出现盲目从众现象。现有的个体评估方法通常基于置信度或困惑度,难以准确反映推理的正确性,甚至可能加剧盲目从众。为此,我们将研究视角从个体评估转向群体交互,将大语言模型之间相互参考的关系定义为辩论关系,并认为调控这些关系是缓解盲目从众的关键。基于此,本文从群体视角出发,提出一种新颖的动态辩论关系调控框架(DEAR)。首先,DEAR 对群体的共识与分歧进行量化,将其作为刻画辩论状态的群体证据。随后,DEAR 通过三个阶段实施调控:1)What:感知群体的求询倾向与不确定性;2)Who:引入选择强化学习智能体,动态选择参考同伴;3)How:采用行为强化学习智能体,自适应调整模型下一轮的生成行为。进一步地,我们将两个强化学习智能体的执行过程建模为序贯决策过程,并通过多智能体强化学习对其进行联合优化。大量实验表明,DEAR 在取得更优性能的同时,显著降低了词元消耗。
论文六
Decoupling Is the Key: Scaling Deep Value Networks in Reinforcement Learning
论文由我所博士生薛云升在我所武志昊老师和林友芳老师的指导下完成,合作者包括已毕业硕士生张梓祎。
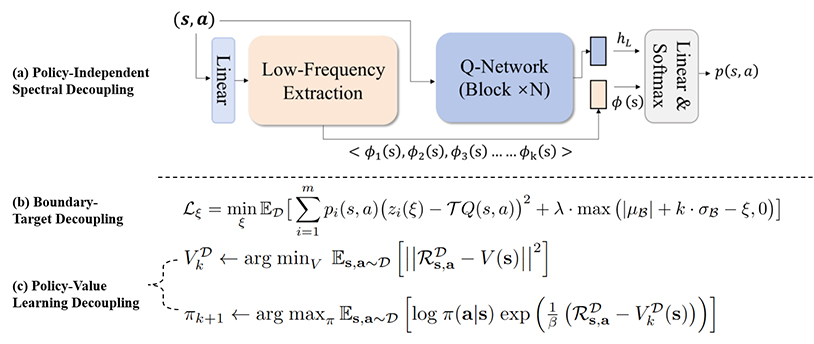
在计算机视觉和自然语言处理领域,通过增加网络深度以提升模型能力已经取得较大的成功。然而,在强化学习算法中,简单地增加价值网络的深度不仅难以带来收益,反而会导致算法性能的显著衰退。针对这一痛点,该研究首先通过严谨的理论与实证分析,揭示了深层网络在强化学习中的失效主要是由于强化学习算法不同组件之间的耦合,导致深层网络出现严重的表征坍缩和过拟合。在此基础之上,该研究进一步提出解耦是实现强化学习深度扩展的核心观点,并针对性地设计了策略独立谱解耦、边界-目标解耦和策略-价值解耦三个核心模块。通过大量的实验表明,在在线和离线环境设置下,本文所提的算法框架均能成功释放价值网络深度扩展所带来的性能潜力,使网络能够从3层稳定扩展至32层,并在更深的网络结构下保持较高的有效秩与极低的神经元休眠率。
论文七
When to Trust Memory: Retrieval-Guided Probabilistic Spatiotemporal Forecasting under Distribution Shift
该论文由我所师生吕皓辰、张建昊、雷祉辰(本科生)、姜洋、毛潇苇,以及郭晟楠老师、林友芳老师、万怀宇老师合作完成。
时空预测在交通、水文、能源等真实场景中发挥着关键作用,概率预测方法还能够输出不确定性估计,为下游决策提供支撑。然而现实世界的时空系统具备非平稳特性,数据会出现分布偏移现象。现有概率预测方法大多聚焦于标准设置下的数据分布建模,而处理分布偏移的相关工作往往处理方式较为粗略,无法量化偏移程度并据此自适应调整预测策略,最终产生校准失效、可靠性差的预测结果。此外,现有的检索增强方法在严重分布偏移场景下,会不加区分复用检索得到的历史样本,引入无关甚至误导信息。本文要解决的核心难题,就是在不同偏移程度下实现可靠的概率时空预测。
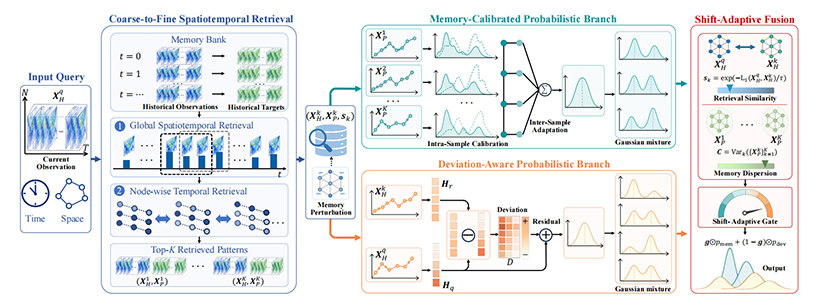
为了解决上述问题,本文提出 REMIND,一套面向分布偏移场景、检索引导的概率时空预测框架。该框架将检索结果作为判断信号,评估当前观测能够被历史模式所支撑的程度,以此实现不同偏移条件下的自适应预测。REMIND 设计由粗到细的时空检索机制来构建记忆库,搭建双分支网络:面向轻微偏移场景的记忆校准概率分支,以及适配严重偏移场景的偏差感知概率分支;基于检索相似度与记忆离散度构建偏移自适应门控,动态平衡两个分支的输出结果。模型进一步设计分层高斯混合结构,捕捉双分支预测所带来的异质性不确定性,同时提出记忆扰动训练策略,提升模型在分布偏移场景下的泛化能力。
论文的相关结论得到了水文、交通、能源领域真实数据集上实验的验证,REMIND 在预测精度以及概率预测质量方面,表现优于对比的前沿方法,为非平稳环境下的概率时空预测提供了一套有效的新思路。
恭喜以上老师和同学在科研中取得优秀的成果,也希望同学们能够再接再厉,继续在科研的道路上不断前行,取得更多优异的成果。